有道翻译已经从神经网络翻译(NMT)过渡到大模型翻译双轨并行。在有道智云的 API 目录里,「大模型文本翻译」与传统「文本翻译 NMT」是两个并列售卖的产品——这最直接地说明了它们同时在跑:大模型负责需要理解上下文和语气的长文本,NMT 负责对速度和成本敏感的高并发场景。
「有道翻译准不准」这个问题背后其实是「它现在用的是哪一代技术」。答案是:不止一代,而且是按场景分工的。
从 API 目录反推技术栈
判断一家公司真实的技术布局,看它对外卖什么 API 比看宣传稿可靠。有道智云(ai.youdao.com)当前的「自然语言翻译」类目下同时列着:
- 大模型文本翻译——基于大语言模型的翻译
- 文本翻译(NMT)——传统神经网络翻译
- 大模型同声传译——大模型驱动的实时口译
- 语音翻译、实时语音翻译、图片翻译、文档翻译、网页翻译、批量文本翻译、语种识别
两套翻译引擎并列售卖,说明它们各有不可替代的场景。大模型胜在上下文理解、语气把握、术语一致性;NMT胜在延迟低、成本低、吞吐高。对接方按需要选,不是简单的「新的替代旧的」。
三个层次的部署位置
| 部署位置 | 典型产品 | 特点 |
|---|---|---|
| 云端大模型 | 有道翻译长文本、AI 同传、文档翻译 | 质量最高,需联网,有算力成本 |
| 云端 NMT | 高并发接口调用、实时字幕 | 快、便宜、稳定 |
| 端侧(设备本地) | 词典笔 X7 系列离线翻译 | 断网可用,受硬件算力限制 |
端侧这一层是有道对外强调的差异点。CES 2025 稿件称其在词典笔 X7 系列中搭载了「the industry's first edge large language model」用于离线翻译,输出「comparable to those of online NMT」。注意这个对标对象是联网 NMT,而不是联网大模型。
自研模型的公开证据
有道的翻译与教育能力都指向同一个自研模型家族——子曰(Confucius)。与很多只发新闻稿的公司不同,有道把其中几个模型开源到了 Hugging Face,这让外部可以直接验证其技术水平,而不必只听宣传:
- Confucius-o1-14B——14B 推理模型,2025-01-22 发布并开源
- Confucius3-Math——14B(Safetensors 显示 15B)K12 数学推理模型,MIT 许可,配套论文 arXiv:2506.18330(2025-06-23)
- Confucius4——27B 多模态数学推理模型,基于 Qwen3.5-27B 微调,Apache 2.0 许可
这几个模型主攻数学与推理,不是翻译模型,但它们证明了子曰家族是真实存在、可下载验证的工程成果,而非纯营销概念。翻译方向的模型目前未见开源版本,具体架构与参数规模待核实。
关于翻译质量的横向对比:有道官方稿件中对翻译质量的表述多为自述,未找到公开的、包含有道最新大模型翻译的第三方权威横评(如 WMT 正式赛道成绩)。选型建议以自己的真实语料实测为准。

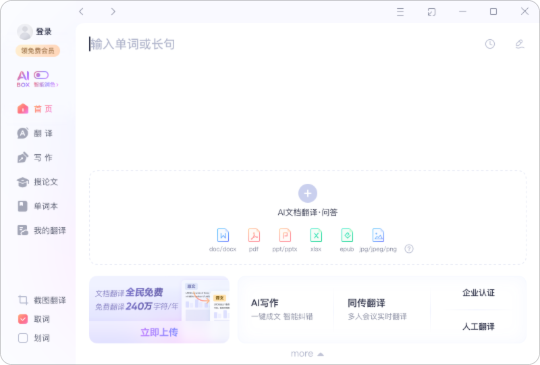
实拍:有道词典 实际运行界面。
资料来源
- 有道智云 AI 开放平台 · 自然语言翻译 API 目录(大模型翻译与 NMT 并列在售)
- Youdao Dictionary Pen Unveils at CES 2025(端侧大模型与离线翻译对标口径,2025-01)
- netease-youdao/Confucius3-Math · Hugging Face(14B / MIT 许可)
- Confucius3-Math 论文(arXiv:2506.18330,2025-06-23)
- netease-youdao/Confucius4 · Hugging Face(27B 多模态 / Apache 2.0)