可以,而且它是这个用途里门槛最低的选择之一。QAnything 是有道开源的本地知识库问答系统,支持完全离线运行(官方说法是「拔掉网线全程可用」),默认纯 CPU 即可在 Windows / Mac / Linux 上跑,唯一依赖是 Docker。许可证是 AGPL-3.0——商用前必须先看清这一点。
「把公司文档喂给 AI,然后能问它问题」是 RAG 最典型的需求。QAnything 的价值在于它把这件事做成了开箱可用的整套系统,而不是一堆需要自己拼的组件。
核心能力
- 完全离线:官方描述是可以「by unplugging the network cable throughout the process」——全程断网使用。这对数据不能出内网的企业是决定性的。
- 跨语言问答:中英文可自由切换提问,与文档本身的语言无关。
- 无文件数量上限:面向大规模语料设计。
- 低硬件门槛:默认纯 CPU 运行,覆盖 Windows / Mac / Linux,唯一依赖是 Docker。
- 组件可替换:PDF 解析、OCR、embedding、rerank 均可替换,且每个都能单独通过 HTTP 调用。
- 多种模式:快速开始、无文件聊天、仅检索、自定义 bot。
支持的文件格式
PDF、DOCX、PPTX、XLSX、Markdown、EML、TXT、图片(jpg / jpeg / png)、CSV,以及 HTML 网页链接。
两阶段检索:为什么重要
QAnything 的检索是先向量召回、再 rerank 重排两步。其给出的理由值得所有做 RAG 的人记住:纯 embedding 检索的效果会随数据量增长而下降,而加入重排后准确率能稳定提升——所以「the more data, the better the performance」(数据越多,表现越好)。
这是很多自建 RAG 项目失败的根本原因:小规模测试时只用向量检索效果不错,上到几万份文档后准确率崩掉,然后归咎于模型不行。实际问题在检索架构,不在生成模型。
检索组件是有道另一个开源项目 BCEmbedding(双语 embedding + reranker)。README 报告的数据:bce-embedding-base_v1 平均 59.43,高于列出的 bge 与 m3e 基线;bce-reranker-base_v1 重排 60.06,对比 bge-reranker-large 的 59.69。这些是项目自报数据,建议用自己的语料复测。
工程状态
| 指标 | 数值 |
|---|---|
| GitHub stars | 约 14.1k |
| Forks | 约 1.3k |
| Commits(qanything-v2 分支) | 约 754 |
| Open issues | 约 399 |
| 许可证 | AGPL-3.0 |
| 2.0 版本发布 | 2024-08-23,合并 Docker 与 Python 两个版本为单一 Docker Compose 启动 |
| 镜像体积优化 | 2.0 中从 18.94GB 压缩到 4.88GB |
官方称 QAnything 已被「hundreds of companies across more than 20 industries」采用,用户「over 30,000」。
两个必须注意的坑
一、AGPL-3.0 的传染性。AGPL 比 GPL 更严格:如果你修改了代码并通过网络提供服务,就需要向使用者提供你修改后的源码。做闭源 SaaS 产品时这是实质性风险,动手之前请让法务看一眼,不要事后补救。
二、内置 LLM 的许可是另一回事。QAnything 的 LLM 部分基于 QwenLM 微调,商用需遵守 Qwen 自身的许可条款。也就是说你要同时满足两套许可要求:QAnything 的 AGPL 和底层模型的 Qwen 许可。这一点很容易被忽略。
如果这两条许可无法接受,可行的替代路径是:只借用它的架构思路(两阶段检索)和BCEmbedding 模型,用许可更宽松的框架自己实现检索层。

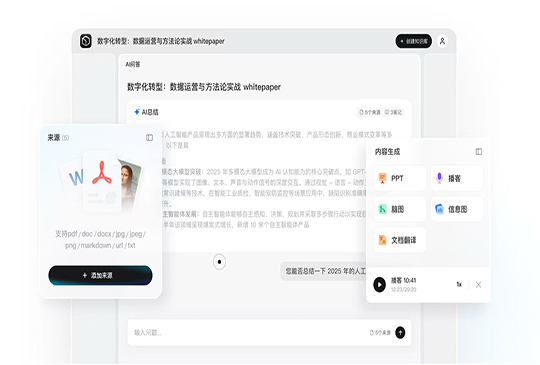
实拍:有道词典 实际运行界面。
资料来源
- netease-youdao/QAnything · GitHub(离线能力、支持格式、两阶段检索、2.0 版本变化、stars 与 issues、AGPL-3.0、Qwen 许可提示)
- netease-youdao/BCEmbedding · GitHub(embedding 与 reranker 基准数据)
- Youdao's Large Language Model Ziyue Takes Center Stage at World AI Conference(QAnything 采用规模与用户数口径,2024-07-11)